Home › Blog › Vindbaar in Google en AI
Vindbaar in Google en AIReddit, reviews en fora: waar AI-antwoorden hun bronnen vandaan halen
Waar halen ChatGPT, Gemini en Perplexity hun bronnen vandaan? Waarom Reddit, reviews en fora zwaar meewegen en hoe jij daartussen komt.
 Zac Bathi, Founder | Digital Strategy Consultant · Gepubliceerd · Bijgewerkt · 6 min leestijd
In het kort
- AI-antwoorden ontstaan via drie routes: trainingsdata, live webzoekopdrachten en licentieafspraken met platforms.
- Reddit weegt zwaar door licentiedeals, eerstehands ervaring en de vraag-en-antwoordstructuur van fora.
- Afgeschermde plekken zoals besloten Facebook-groepen zijn voor crawlers onbereikbaar en tellen nauwelijks mee.
Vraag je ChatGPT om een aanrader, dan komt dat antwoord ergens vandaan: Reddit-draden, reviewsites, vergelijkingsartikelen en soms jouw eigen website. Na dit artikel weet je welke bronnen elk AI-platform gebruikt en waar jij aanwezig moet zijn om genoemd te worden. Dat maakt het verschil tussen meedoen in AI-antwoorden en er structureel buiten vallen.
Drie routes van bron naar AI-antwoord
Een AI-antwoord lijkt uit het niets te komen, maar elk onderdeel is terug te voeren op bronnen. Die bereiken het antwoord via drie routes.
- Trainingsdata. Het model is getraind op een enorme momentopname van het web: artikelen, fora, reviews, documentatie en boeken. Wat daar vaak en consistent over jouw vakgebied stond, vormt de basiskennis van het model. Deze laag loopt per definitie achter op de werkelijkheid.
- Live webzoekopdrachten. Stelt iemand een actuele vraag, dan zoeken ChatGPT, Gemini, Perplexity en Copilot live op het web. Ze halen een handvol pagina's op, vatten die samen en tonen citaties. Wie hier geciteerd wordt, bepaalt het antwoord van dat moment.
- Licentieafspraken. AI-bedrijven sloten overeenkomsten met platforms zoals Reddit om hun content te mogen gebruiken. Content van die platforms is daardoor extra goed vertegenwoordigd in antwoorden.
Voor jou als ondernemer tellen vooral route twee en drie: daar kun je op korte termijn iets aan veranderen. De trainingslaag volgt vanzelf als correcte informatie over je merk lang genoeg breed op het web staat.
Waarom Reddit en fora zo zwaar meewegen
Reddit duikt opvallend vaak op in AI-antwoorden, zeker bij koop- en ervaringsvragen. Daar zijn concrete redenen voor.
- Eerstehands ervaring. Mensen beschrijven op fora wat ze zelf meemaakten, inclusief de nadelen. Dat is precies het soort informatie dat AI-systemen zoeken als tegenwicht voor commerciële teksten.
- Vraag-en-antwoordstructuur. Een forumdraad lijkt qua vorm op een prompt met mogelijke antwoorden. Die structuur is voor taalmodellen makkelijk te verwerken en samen te vatten.
- Stemmen als kwaliteitsfilter. Upvotes en moderatie geven een ruwe indicatie van welke antwoorden de community betrouwbaar vindt.
- Zoekmachines duwden fora al omhoog. Google toont forumresultaten prominenter dan een paar jaar terug, en AI-systemen die op zoekresultaten leunen erven die voorkeur.
Hetzelfde geldt in mindere mate voor gespecialiseerde vakfora en communities. Afgeschermde plekken zoals besloten Facebook-groepen zijn voor crawlers onbereikbaar en tellen dus nauwelijks mee.
Reviews, vergelijkers en de rest van het bronnenpalet
Naast fora put AI uit een vast rijtje brontypen. Stel je een koopvraag, dan zie je in de citaties meestal deze mix:
- Reviewplatforms: onafhankelijke beoordelingen wegen zwaar bij vragen over de betrouwbaarheid van bedrijven en producten.
- Vergelijkingsartikelen en koopgidsen: lijstjes van het type beste-x-voor-y worden vaak vrijwel integraal als bron gebruikt.
- Wikipedia en naslagwerken: voor feitelijke vragen over bedrijven, personen en begrippen.
- Nieuwssites en vakmedia: voor actualiteit en autoriteit binnen een branche.
- Je eigen website: voor prijzen, diensten en bedrijfsinformatie, mits die pagina's helder, actueel en goed geïndexeerd zijn.
Welke bron wint, hangt af van de vraag. Een vraag over boormachines levert andere bronnen op dan een vraag over boekhouders. Breng daarom per kernvraag in kaart welke bronnen de AI-assistenten in jouw markt citeren: stel elke assistent dezelfde vragen en noteer de citaties.
Zo kom je zelf in die bronnen terecht
Aanwezigheid in AI-bronnen bouw je in deze volgorde op:
- Maak je bronnenlijst. Stel ChatGPT, Gemini, Perplexity en Copilot tien vragen die klanten over jouw markt stellen. Elke geciteerde bron gaat op de lijst, met een turfje per keer dat die terugkomt.
- Claim de makkelijke plekken. Reviewprofielen, branchegidsen en vergelijkers waar je jezelf kunt aanmelden. Vul ze volledig in en houd ze actueel.
- Doe mee waar het gesprek plaatsvindt. Beantwoord vragen op fora en Reddit vanuit je expertise, wees open over wie je bent en link alleen als het echt helpt. Communities ruiken reclame direct.
- Word vermeldenswaardig. Publiceer iets wat koopgidsen en vakmedia willen aanhalen: originele data, een gratis tool, een uitzonderlijk complete handleiding.
- Versterk je eigen domein. Hoe hoger je domein-autoriteit, hoe vaker zoekgedreven AI-antwoorden jouw pagina's ophalen en citeren in plaats van die van een tussenpartij.
Veelgemaakte fouten in het werken aan AI-bronnen
Deze missers kosten tijd of werken zelfs tegen je:
- Nepposts op Reddit plaatsen. Accounts die alleen het eigen bedrijf aanprijzen worden verwijderd en beschadigen je naam blijvend. Fix: reageer als herkenbare expert en houd zelfpromotie minimaal.
- Alleen aan de eigen site werken. AI combineert bronnen; een perfecte website zonder externe vermeldingen blijft onzichtbaar bij ervaringsvragen. Fix: verdeel je tijd tussen je site en externe aanwezigheid.
- Reviews laten verstoffen. Een handjevol oude beoordelingen weegt licht. Fix: vraag structureel om reviews na elke levering of afgeronde klus.
- Overal tegelijk willen zijn. Tien platforms half bijhouden levert minder op dan drie goed. Fix: kies de bronnen die aantoonbaar geciteerd worden in jouw markt.
- Niet meten. Zonder meting weet je niet of je aanwezigheid iets oplevert. Fix: herhaal je vragenset maandelijks en volg of jouw naam vaker valt.
Wat ViRank hierbij doet
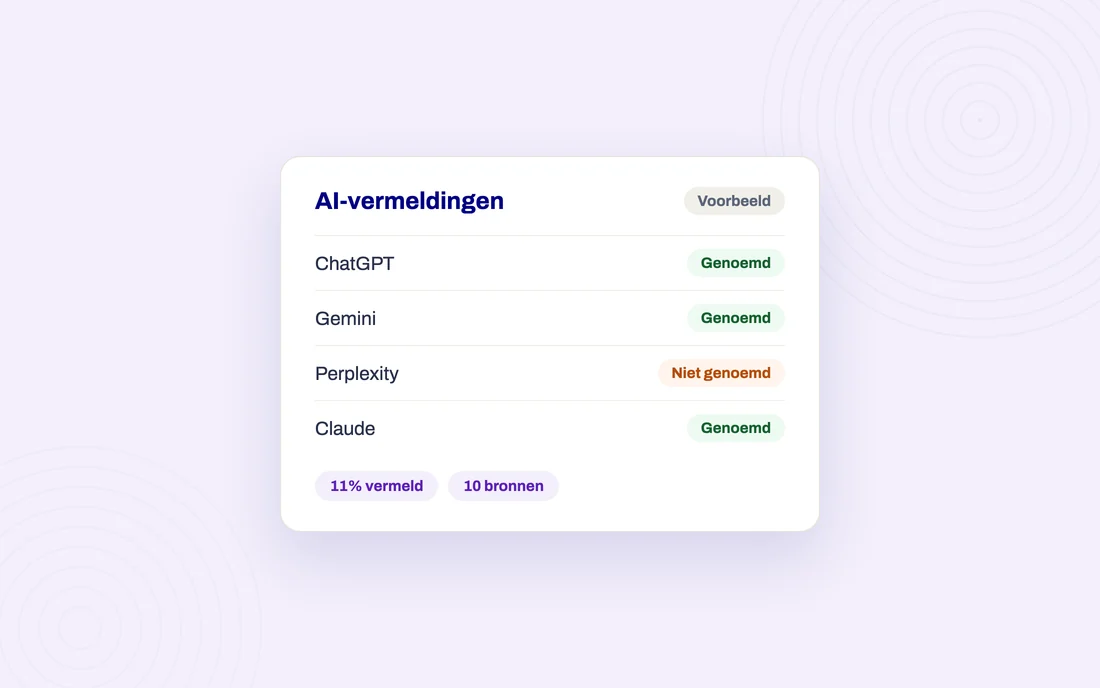
Die vragenset handmatig afwerken in vier AI-assistenten kost elke keer flink wat tijd. ViRank neemt een groot deel van dat meetwerk over: op het scherm AI-vindbaarheid start je een meting die nagaat of jouw merk genoemd wordt in ChatGPT, Gemini, Perplexity en Claude, zodat je ziet bij welke vragen je ontbreekt en welke concurrent daar nu staat. Copilot uit je vragenset controleer je zelf. ViRank vertaalt dat samen met de rest van het platform naar acties, gesorteerd op wat naar verwachting het meeste oplevert. Wat ViRank op je WordPress-site uitvoert, gebeurt standaard pas na jouw akkoord, en elke wijziging is terug te draaien. De eerste 14 dagen zijn gratis, zonder creditcard.
Veelgestelde vragen
Gebruikt ChatGPT Google om bronnen te vinden?
Nee. ChatGPT gebruikt een eigen crawler en steunt op de zoekindex van Bing. Gemini leunt juist op de zoekinfrastructuur van Google, en Perplexity combineert eigen crawlers met een eigen index. Daarom kan hetzelfde bedrijf in de ene assistent wel genoemd worden en in de andere niet. Wil je overal zichtbaar zijn, zorg dan dat zowel Google als Bing je site volledig geïndexeerd hebben.
Mag ik zelf op Reddit over mijn bedrijf schrijven?
Dat mag, zolang je transparant bent over je rol en de regels van de betreffende subreddit volgt. Veel communities staan een eigenaar toe die vragen beantwoordt, maar verwijderen verkapte reclame direct. De veiligste route: bouw eerst reputatie op met behulpzame antwoorden zonder link, en noem je bedrijf alleen waar dat het antwoord aantoonbaar beter maakt.
Hoe zie ik welke bronnen een AI-antwoord gebruikte?
Perplexity toont bij elk antwoord genummerde bronvermeldingen. ChatGPT laat links naar de gebruikte pagina's zien wanneer het live gezocht heeft, net als Copilot. Gemini toont bronnen onder een deel van de antwoorden. Antwoorden zonder citaties komen meestal uit de modelkennis zelf; daarvan valt de herkomst niet exact te achterhalen, al weerspiegelt die kennis wat breed op het web over een onderwerp geschreven staat.
Weegt nieuwe content zwaarder dan oude?
Voor de zoeklaag wel: live zoekende assistenten geven voorrang aan actuele, recent bijgewerkte pagina's, zeker als de vraag een tijdsaspect heeft. Voor de trainingslaag geldt het omgekeerde: daar telt wat er stond op het moment van de momentopname, soms langer dan een jaar geleden. Onderhoud daarom beide sporen: houd kernpagina's actueel en zorg dat correcte informatie lang genoeg online staat om in trainingsdata terecht te komen.
Bronnen en verder lezen
Bijgewerkt op 11 oktober 2026: overgezet naar de blog van ViVortis en de ViRank-feiten nagelopen. Eerste versie 15 augustus 2026.
Over de schrijver
Zac Bathi
Oprichter van ViVortis (sinds 2018). Bouwde met zijn team meer dan 700 websites en webshops en ontwikkelt ViRank en ViPayments. Schrijft over wat hij bij klanten ziet werken in websites, vindbaarheid en software.